Claude Opus 4.8: Anthropic punta sugli agenti AI
Claude Opus 4.8 è arrivato il 28 maggio 2026 con fast mode fino a 2,5 volte più veloce e tre volte più economico rispetto ai modelli precedenti, secondo Anthropic, mentre il prezzo standard resta a 5 dollari per milione di token in input e 25 in output. Il punto non è solo che l’ultimo modello Opus costa meno in una modalità specifica: è che Anthropic sta vendendo un modello più affidabile, più “onesto” e più adatto a orchestrare lavoro agentico lungo.
La tensione è evidente. Dopo due anni in cui il mercato ha inseguito benchmark e finestre di contesto, la nuova competizione si sta spostando su una domanda più severa: un modello sa fermarsi, dichiarare incertezza, controllare il proprio lavoro e coordinare altri agenti senza produrre una cascata di errori plausibili? Claude Opus 4.8 nasce dentro questa fase, dove l’AI non deve solo rispondere bene, ma lavorare abbastanza a lungo da diventare infrastruttura.
Come funziona Claude Opus 4.8 negli agenti AI
Claude Opus 4.8 non viene presentato da Anthropic come una rottura architetturale pubblica, ma come un aggiornamento operativo della famiglia Opus. Nella documentazione API, il modello claude-opus-4-8 è descritto come il più capace tra quelli generalmente disponibili per ragionamento complesso, coding agentico di lungo periodo e lavoro ad alta autonomia. La finestra di contesto arriva a 1 milione di token su Claude API, Amazon Bedrock e Vertex AI, mentre su Microsoft Foundry resta a 200.000 token; l’output massimo dichiarato arriva a 128.000 token.
Questi numeri contano perché gli agenti non lavorano come chatbot. Un agente che migra una codebase o analizza contratti non legge una domanda e scrive una risposta: accumula file, istruzioni, errori di test, vincoli di sicurezza, decisioni intermedie e revisioni. Più il contesto resta stabile, meno il sistema deve comprimere o ricostruire memoria, due passaggi in cui spesso nascono omissioni e allucinazioni.
“Claude Opus 4.8 supports the 1M token context window” — Anthropic, Claude API docs
Il secondo elemento è l’adaptive thinking, cioè la possibilità per il modello di attivare ragionamento più profondo solo quando lo ritiene necessario. L’effort control permette invece agli utenti di scegliere quanta energia computazionale assegnare al compito: più bassa per risposte rapide, più alta per problemi complessi.
La novità più pratica per sviluppatori è l’inserimento di messaggi system dentro l’array dei messaggi a metà conversazione. Un’applicazione può aggiornare permessi, budget, contesto o policy durante un task senza riscrivere l’intero prompt iniziale. È una modifica apparentemente tecnica, ma segna il passaggio da prompt statici a regia continua dell’agente.
Claude Opus 4.8 è più onesto, ma i limiti restano

Anthropic insiste su una parola meno spettacolare di “intelligenza”: onestà. Nel comunicato ufficiale, l’azienda scrive che Opus 4.8 è più incline a segnalare incertezze sul proprio lavoro e meno incline a fare affermazioni non supportate. Il dato più interessante riguarda il codice: nelle valutazioni interne, Opus 4.8 sarebbe circa quattro volte meno propenso di Opus 4.7 a lasciare passare inosservati difetti nel codice che ha scritto.
“around four times less likely than its predecessor to allow flaws in code it has written to pass unremarked” — Anthropic
È un miglioramento importante perché tocca una delle fragilità più pericolose dei modelli linguistici: non l’errore evidente, ma l’errore convincente. Un modello che inventa una funzione, cita una fonte inesistente o dichiara completato un task mai verificato non fallisce come un software tradizionale. Fallisce producendo fiducia. Per questo “più onesto” non significa “senza allucinazioni”; significa, se le valutazioni reggono fuori dai laboratori, meno propenso a trasformare in certezza ciò che dovrebbe restare ipotesi.
Il limite è che la metrica resta interna ad Anthropic e non equivale a una garanzia in produzione. La stessa azienda definisce Opus 4.8 un miglioramento “modest but tangible”, non un salto definitivo verso modelli infallibili. Inoltre, i costi non spariscono: la modalità standard resta a 5 dollari/Mtok input e 25 dollari/Mtok output; la fast mode costa 10 e 50 dollari. Il “3x più economico” riguarda la modalità veloce rispetto ai modelli precedenti, non un taglio generalizzato del listino Opus.
La domanda che nessun benchmark può risolvere da solo è semplice: quante aziende misureranno il costo di un workflow riuscito, invece del costo per milione di token? Senza questa metrica, un modello più onesto può comunque diventare caro, se lavora troppo a lungo su problemi mal definiti.
Dynamic workflows: centinaia di agenti, non una chat più lunga
Chi segue il settore da vicino sa che la parola “agente” è stata usata spesso con troppa generosità. In Claude Code, però, i dynamic workflows descritti da Anthropic indicano qualcosa di più concreto: il sistema pianifica un lavoro, lo divide in sottocompiti, avvia subagenti paralleli, verifica gli output e ricompone il risultato prima di tornare all’utente.
Secondo Anthropic, la funzione può eseguire “hundreds of parallel subagents” in una singola sessione. Non c’è, nelle fonti ufficiali disponibili, una promessa verificata di migliaia di agenti: il dato pubblico solido è “centinaia”. Ma il punto strategico resta enorme, perché centinaia di agenti coordinati cambiano la scala del lavoro affrontabile da un singolo ambiente di sviluppo.
“hundreds of agents working in parallel with two reviewers on each file” — Claude Code dynamic workflows
L’esempio più forte è la riscrittura di Bun da Zig a Rust. Anthropic cita circa 750.000 linee di Rust, 99,8% della test suite esistente passata e undici giorni dal primo commit al merge. Un workflow ha mappato i lifetime Rust per ogni campo struct; un altro ha scritto file .rs come port comportamentalmente equivalenti dei file .zig; un ciclo successivo ha guidato build e test fino alla pulizia. Anthropic precisa che non è ancora produzione, e questo dettaglio va mantenuto: è una prova di scala, non una certificazione industriale.
Qui Claude Opus 4.8 sposta la competizione. Non basta più dire che un modello risponde meglio a SWE-bench o ragiona più a lungo. Il valore si misura nella capacità di mantenere coerenza tra piano, strumenti, verifiche e revisori automatici. Per le applicazioni AI professionali, la nuova domanda diventa: il sistema sa completare un processo, o produce solo una lunga sequenza di testo plausibile?
Il vero tema è il costo dell’autonomia
Il dato economico più importante di Claude Opus 4.8 non è il prezzo API standard, ma il costo necessario per ottenere un task completato in modo affidabile. Anthropic dice che la fast mode può lavorare a 2,5 volte la velocità ed è tre volte più economica rispetto alla fast mode dei modelli precedenti. Ma il prezzo normale resta 5 dollari per milione di token in input e 25 dollari per milione di token in output; la fast mode costa invece 10 dollari in input e 50 in output.
Questo significa che “3x più economico” non va letto come “Opus 4.8 costa meno del normale”. Va letto in modo più preciso: costa meno rispetto alla precedente modalità veloce. Per chi usa agenti lunghi, la differenza è decisiva, perché il costo reale non nasce dal singolo prompt, ma dalla catena completa: pianificazione, chiamate a strumenti, subagenti, test, revisione, retry, correzioni e output finale.
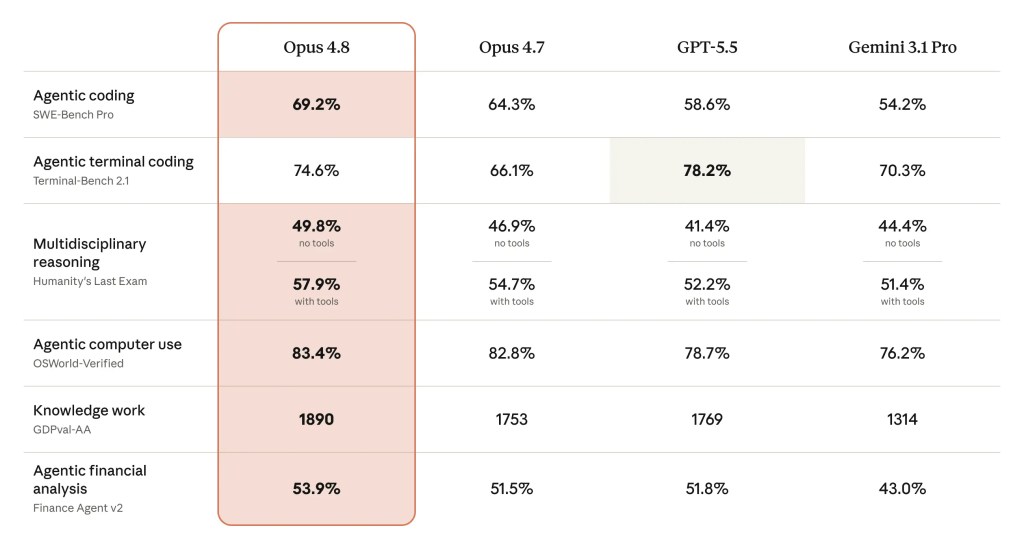
Il benchmark più utile per capirlo è OSWorld-Verified, che misura l’uso agentico del computer. Nella tabella pubblicata da Anthropic, Claude Opus 4.8 arriva all’83,4%, contro l’82,8% di Opus 4.7: appena +0,6 punti percentuali. È un miglioramento, ma non abbastanza grande da giustificare da solo una narrativa trionfale. Nei task agentici lunghi, il punto non è solo se il modello sia più potente; è quanto costa ottenere quel completamento corretto, verificato e ripetibile.
“Dynamic workflows can consume substantially more tokens than a typical Claude Code session” — Anthropic, Claude Code
Il contrappeso arriva da Terminal-Bench 2.1, benchmark di coding agentico da terminale. Con lo stesso harness pubblico Terminus-2, Opus 4.8 ottiene il 74,6%, mentre GPT-5.5 arriva al 78,2%. La lettura corretta non è che Opus 4.8 “vince” o “perde” in assoluto. È che su alcuni workflow terminal-heavy un concorrente resta avanti, quindi scegliere un modello sulla base di un singolo punteggio o del prezzo per token è una semplificazione pericolosa.
Per le aziende italiane, soprattutto PMI, software house e studi professionali, la metrica editoriale e operativa dovrebbe diventare un’altra: costo per task completato. Non “quanto costa un milione di token”, ma quanto costa chiudere una migrazione, correggere un bug, revisionare un contratto, produrre un report o completare una due diligence con un errore residuo accettabile.
Le metriche da misurare sono quattro: costo medio per task riuscito, tempo umano risparmiato, tasso di errore residuo e numero di interventi di revisione necessari. Solo a quel punto il confronto tra Claude Opus 4.8, GPT-5.5 o altri modelli smette di essere marketing e diventa una decisione aziendale. Il dato finale resta quello più concreto: su Terminal-Bench 2.1, Opus 4.8 segna il 74,6%, GPT-5.5 il 78,2%.
Fonti citate
- Introducing Claude Opus 4.8 , Anthropic, 28 maggio 2026.
- Introducing dynamic workflows in Claude Code , Claude / Anthropic, 28 maggio 2026.