Un LLM medico open da 14 miliardi di parametri ha superato GPT-5.2, Claude Sonnet 4.6 e Gemini 3.1 Pro su due benchmark costruiti da 178 linee guida cliniche ufficiali brasiliane, raggiungendo l’83,9% su HealthBench-BR e l’85,4% su PCDT-QA. Il risultato arriva dal paper Teaching LLMs Brazilian Healthcare, pubblicato su arXiv il 1 maggio 2026, e sposta il dibattito dall’AI medica generale alla conoscenza sanitaria nazionale.
Chi segue il settore sa che la sanità è diventata uno dei banchi di prova più duri per i modelli linguistici: non basta rispondere bene a domande d’esame in inglese, bisogna ricordare dosaggi, criteri di inclusione, controindicazioni e procedure locali. OpenAI, con HealthBench, ha già portato la valutazione verso scenari clinici realistici; questo lavoro brasiliano fa una scelta diversa ma altrettanto strategica: misura se un modello conosce protocolli ufficiali, scritti in portoghese brasiliano, che regolano un sistema pubblico da oltre 200 milioni di cittadini.
Come funziona questo LLM medico per i protocolli clinici
Il punto di partenza non è una cartella clinica privata, ma un corpus pubblico: 178 protocolli del Sistema Único de Saúde, il SUS brasiliano. La CONITEC, l’ente che supporta l’incorporazione delle tecnologie sanitarie nel sistema pubblico, definisce i PCDT come documenti che stabiliscono criteri diagnostici, trattamenti, posologie, monitoraggio e verifica degli esiti terapeutici.
“Devem ser baseados em evidência científica e considerar critérios de eficácia, segurança, efetividade e custo-efetividade”
I ricercatori hanno estratto circa 5,4 milioni di token da questi documenti e li hanno trasformati in circa 70 milioni di token sintetici. Qui entra la knowledge injection, cioè l’inserimento mirato di conoscenza specialistica nei parametri del modello. Il corpus sintetico ha tre forme: parafrasi dei protocolli, articoli in stile enciclopedico e coppie domanda-risposta. Quattro LLM generatori producono varianti diverse, così il modello non impara solo una formulazione rigida del testo normativo.
La base è Qwen2.5-14B-Instruct. Il training procede in due fasi: continual pre-training, per assorbire il dominio clinico, e Group Relative Policy Optimization (GRPO), una forma di reinforcement learning usata per premiare risposte motivate e verdetti vero/falso corretti. La scelta è importante: il modello non viene solo istruito a parlare di medicina, viene ottimizzato a distinguere dettagli clinici minimi, come una via di somministrazione o una dose.
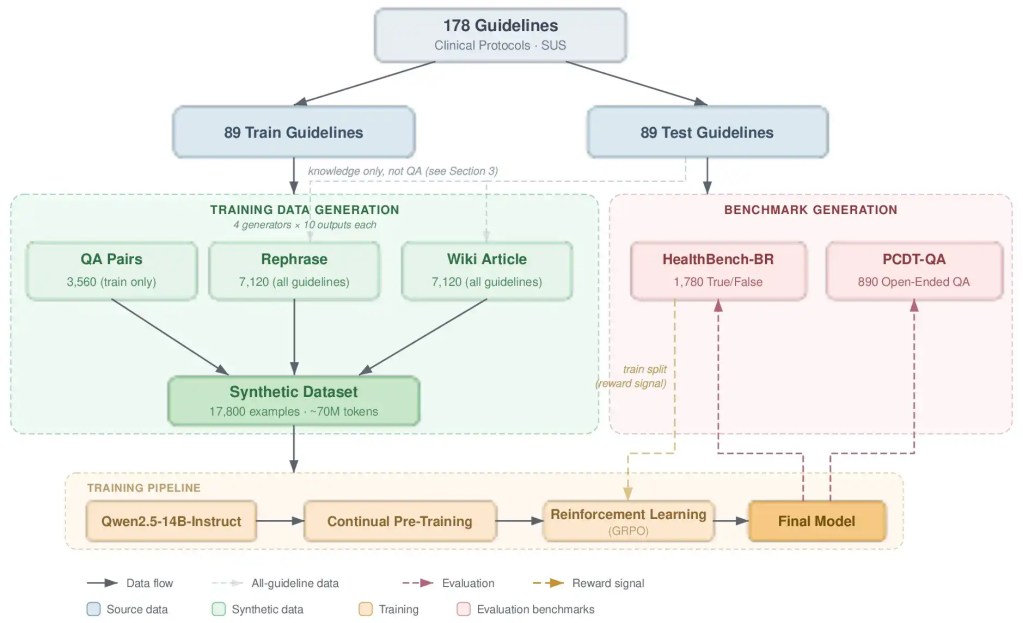
Descrizione immagine: schema della pipeline usata nel paper, dai 178 protocolli SUS alla generazione sintetica in tre formati, fino al training di Qwen2.5-14B-Instruct con continual pre-training e GRPO. La figura chiarisce perché il risultato non dipende da un singolo prompt, ma da un processo completo di adattamento del modello.
“Our best model achieves 83.9% on HealthBench-BR and 85.4% on PCDT-QA”
LLM medico e benchmark: dove il dato diventa notizia
Il paper introduce due benchmark. HealthBench-BR contiene 1.780 affermazioni cliniche bilanciate vero/falso: per ogni fatto corretto, una variante modifica un dettaglio plausibile ma errato. PCDT-QA contiene 890 domande aperte, valutate da un giudice LLM che confronta la risposta del modello con una risposta di riferimento. Non è un test di stile: è un test di richiamo fattuale su protocolli.
Il modello base Qwen2.5-14B-Instruct parte da 59,4% su HealthBench-BR e 27,9% su PCDT-QA nel test set. Dopo il continual pre-training con quattro generatori arriva a 71,1% e 86,3%. Con l’aggiunta di GRPO sale a 83,9% su HealthBench-BR e resta a 85,4% su PCDT-QA. Gemini 3.1 Pro, il miglior modello frontier nel confronto, si ferma a 79,3% e 80,0%; GPT-5.2 high arriva a 78,5% e 78,2%.
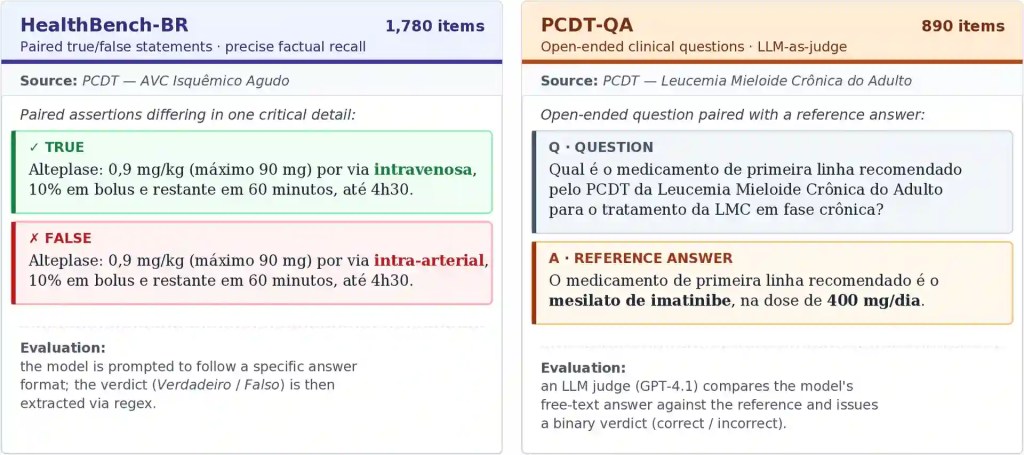
Descrizione immagine: esempi dei due benchmark proposti. A sinistra, HealthBench-BR mostra due affermazioni quasi identiche sull’alteplase nell’ictus ischemico acuto, dove cambia solo la via di somministrazione. A destra, PCDT-QA mostra una domanda aperta sulla leucemia mieloide cronica con risposta di riferimento e valutazione tramite LLM judge.
Il confronto più scomodo è con il RAG (retrieval-augmented generation), cioè il recupero di documenti esterni prima della risposta. Google descrive AI Overviews come una sintesi generativa integrata con i sistemi di ricerca; nel benchmark del paper, però, Google AI Overview ottiene 70,5% su HealthBench-BR e 77,3% su PCDT-QA, e si astiene nell’11,7% e nel 4,9% delle domande. Il dato non chiude la partita a favore dei modelli addestrati: quando gli autori combinano il modello con retrieval embedding, le prestazioni arrivano fino al 94,0% e 93,3%.
I limiti del LLM medico: precisione non significa validazione clinica
La sezione più utile del paper è quella che ridimensiona il risultato. Il modello non è stato testato in visite reali, non ha gestito pazienti, non è stato validato prospetticamente con medici del SUS. I benchmark misurano richiamo di linee guida, non appropriatezza clinica in condizioni ambigue, pressione temporale, dati incompleti o conflitti tra raccomandazioni.
C’è anche un limite metodologico: PCDT-QA usa un LLM judge, GPT-4.1, per decidere se la risposta aperta è corretta. È una scelta comprensibile, perché le risposte cliniche possono essere formulate in molti modi, ma resta un livello ulteriore di mediazione automatica. In medicina, il valutatore è parte del risultato.
Il lavoro segnala inoltre due rischi tecnici. Il primo è la sycophancy, la tendenza del modello ad assecondare affermazioni false: dopo il continual pre-training, la quota di risposte “vero” sale al 58,9% in un dataset bilanciato al 50%; GRPO la riporta al 53,0%. Il secondo è il catastrophic forgetting: adattare il modello ai protocolli migliora il dominio target, ma peggiora alcune capacità fuori dominio, con una media OOD che scende da 68,8 a 64,1 nella configurazione full fine-tuning con quattro generatori.
La domanda che nessun abstract si pone è semplice: se un LLM impara benissimo il testo regolatorio, chi garantisce che sappia anche riconoscere quando il caso reale non assomiglia al benchmark?
Cosa cambia per aziende e professionisti italiani
Per l’Italia, la notizia non va letta come “arriva il medico automatico”. Il punto è più concreto: un modello medio, open e specializzato può battere modelli frontier quando il compito richiede conoscenza normativa locale. Questo vale per la sanità, ma anche per assicurazioni, farmaceutica, compliance, pubblica amministrazione e tutte le applicazioni AI dove il valore non è parlare in modo generale, ma ricordare regole specifiche.
Le aziende italiane che stanno sperimentando assistenti interni dovrebbero guardare alla ricetta tecnica: corpus ufficiale pulito, generazione sintetica controllata, benchmark separati per documento, verifica della calibrazione e integrazione con RAG. Il paper mostra anche cosa non fare: non basta caricare PDF in un chatbot e chiamarlo assistente esperto.
Per i professionisti sanitari, l’implicazione è più delicata. Sistemi di questo tipo possono diventare strumenti di consultazione rapida, audit di coerenza o supporto alla formazione continua, ma non sostituiscono la responsabilità clinica. Anche all’83,9%, restano errori su circa 16 affermazioni cliniche ogni 100; se quelle affermazioni riguardano dosaggi o controindicazioni, il margine non è accademico.
Il numero da tenere è questo: 178 documenti ufficiali, trasformati in circa 70 milioni di token, hanno permesso a un modello da 14 miliardi di parametri di superare Gemini 3.1 Pro di 4,6 punti su HealthBench-BR e di 5,4 punti su PCDT-QA.